Разговор про локальные модели обычно начинается не с той стороны: с названий моделей и цифр производительности. На практике всё решает одно — сколько памяти доступно модели и как быстро она из этой памяти читается. У компьютеров на Apple Silicon здесь особая конструкция, и она объясняет, почему на маке средней цены иногда работает то, что на игровом компьютере не запускается.
Статья для тех, кто хочет держать модель у себя: без единого файла, уходящего наружу, и без ежемесячной подписки. Никаких настроек — только устройство и здравый расчёт.
Модель — это файл, который целиком лежит в памяти
Языковая модель — набор чисел, весов. Чтобы она отвечала, эти числа должны лежать в быстрой памяти, к которой у вычислителя есть прямой доступ. Не «загружаться по мере надобности», а лежать целиком.
Отсюда первое правило: модель либо помещается, либо не работает. Не «работает медленнее» — именно не работает или работает так, что пользоваться невозможно.
Второе следствие менее очевидно. Когда модель отвечает, она для каждого следующего слова заново пробегает по всем своим весам. Скорость ответа упирается не в то, насколько быстро процессор считает, а в то, насколько быстро он читает память. Инженеры говорят: задача упирается в пропускную способность памяти, а не в вычисления.
Из этих двух фактов вытекает всё остальное.
В чём разница конструкций
Обычный компьютер с видеокартой. Есть оперативная память — её много, она сравнительно дешёвая. И есть отдельная память видеокарты — её мало, она очень быстрая. Модель должна поместиться в память видеокарты; если не помещается, часть уходит в обычную память, и скорость падает в разы, потому что данные начинают ездить между двумя устройствами.
Apple Silicon. Память одна на всех: процессор, графическое ядро и вычислитель для нейросетей обращаются к одному и тому же пулу. Это называется единой памятью. Никакого «перекладывания» между видеокартой и системой не происходит, потому что перекладывать некуда — память общая.
Практическое следствие простое: на маке модели доступно почти столько памяти, сколько её в компьютере. Не отдельные несколько гигабайт видеопамяти, а общий объём за вычетом того, что занято системой.
Именно поэтому ноутбук с 32 или 64 гигабайтами памяти запускает модели, для которых на обычном компьютере нужна дорогая видеокарта или две.
Чего это не отменяет
Честность важнее удобной картины, поэтому сразу об ограничениях.
Мощная видеокарта быстрее. Её память имеет большую пропускную способность, и на моделях, которые в неё помещаются, она выдаёт больше слов в секунду. Преимущество мака не в скорости, а в том, что у него помещается то, что в видеокарту не влезло.
Обучать модели на маке неудобно. Всё сказанное относится к работе готовой модели, а не к её обучению. Обучение — другая задача с другими требованиями, и там правила иные.
Память нельзя добавить потом. В этих компьютерах она распаяна. Сколько купили — столько и будет на весь срок службы. Это, пожалуй, главное практическое соображение при покупке: памяти берут с запасом, потому что докупить её нельзя ни за какие деньги.
Как прикинуть, что поместится
Расчёт грубый, но для решения его достаточно.
Шаг 1. Считаем доступную память. Из общего объёма вычитаем то, что занимает система и открытые программы. Разумно рассчитывать примерно на две трети — остальное уйдёт на macOS, браузер и саму программу, которая запускает модель.
Шаг 2. Оцениваем размер модели. Модели распространяются в сжатом виде — это называется квантованием. В самом ходовом варианте сжатия модель занимает примерно половину гигабайта на каждый миллиард параметров. Модель на 8 миллиардов параметров — около 4–5 гигабайт, на 14 миллиардов — около 8–9, на 70 миллиардов — около 40.
Шаг 3. Добавляем запас на разговор. Чем длиннее переписка и чем больше текста вы даёте модели за раз, тем больше памяти уходит на удержание контекста. Это не мелочь: на длинных документах запас может составлять несколько гигабайт.
Шаг 4. Сравниваем. Если модель с запасом влезает в две трети памяти — она будет работать. Если впритык — начнутся замедления, как только вы откроете что-то ещё.
Ориентир по классам, без привязки к конкретным названиям, которые всё равно поменяются за полгода:
- 16 гигабайт. Небольшие модели — примерно до 8 миллиардов параметров. Хватает на переписывание текста, короткие пересказы, объяснение терминов, поиск по своим заметкам.
- 32 гигабайта. Средние модели, 14–30 миллиардов. Заметно лучше держат рассуждение и длинные документы. Разумная точка для повседневной работы.
- 64 гигабайта и больше. Крупные модели. Появляется смысл там, где нужен разбор длинных материалов и качество, сравнимое с облачными сервисами.
Что это даёт в работе
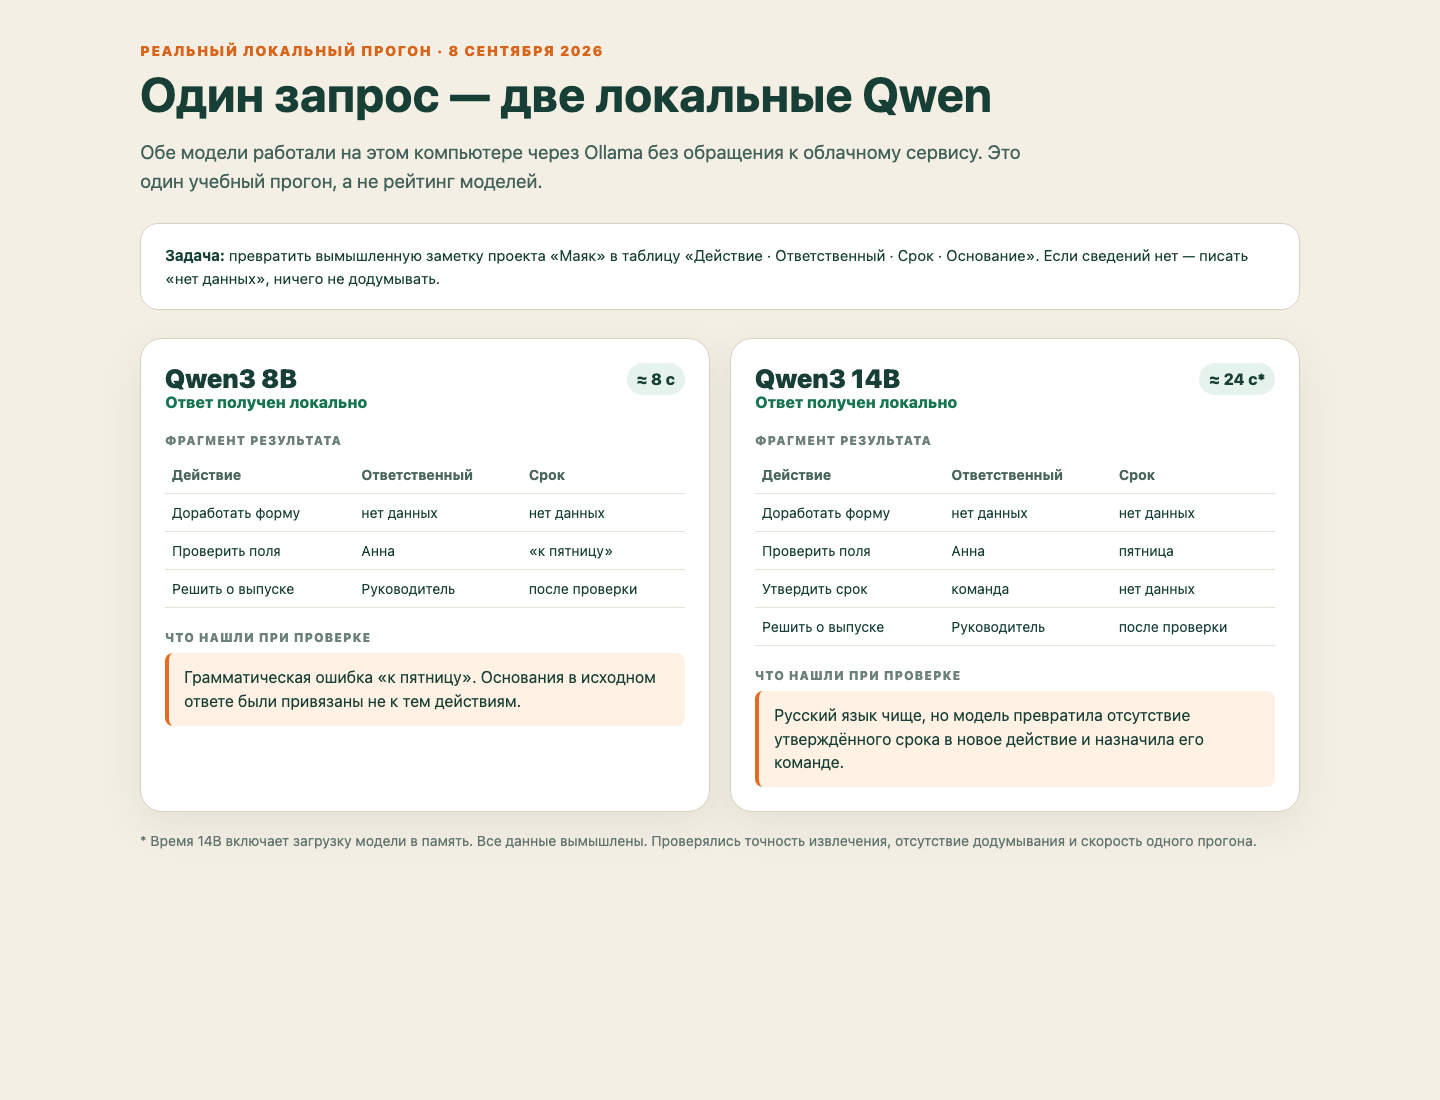
Вот проверка на практике. 8 сентября 2026 года две уже установленные модели — Qwen3 8B и Qwen3 14B — получили один вымышленный офисный текст через Ollama. 8B закончила примерно за 8 секунд, 14B — примерно за 24 секунды вместе с загрузкой модели в память. Обе ответили полностью локально.
Открыть результаты и найденные ошибки →
Более крупная модель написала чище, но всё равно додумала действие и ответственного, которых в заметке не было. Поэтому локальность решает вопрос маршрута данных, но не вопрос достоверности: результат проверяется теми же приёмами, что и ответ облачной модели. Один прогон показывает рабочий сценарий, а не даёт универсальный рейтинг скорости.
Данные не покидают компьютер. Главная причина, по которой этим стоит заниматься в офисе. Расшифровка совещания, черновик документа, разбор внутренней переписки — всё остаётся у вас, и это проверяется: отключите интернет и убедитесь, что модель продолжает отвечать.
Нет счётчика. Ни лимитов, ни платы за объём. Часовая запись, которую жалко отдавать в облако из-за расхода, локально обрабатывается столько раз, сколько нужно.
Работает без сети. В самолёте, на объекте, в переговорной без интернета.
И честно о слабых местах. Локальная модель уступает лучшим облачным в качестве рассуждения. Она не знает свежих событий и не ходит в интернет, если её к нему специально не подключили. Она медленнее — ответ идёт со скоростью чтения, а не мгновенно.
Поэтому разумная схема — не «вместо», а «рядом»: чувствительное и объёмное считается дома, сложное и требующее свежих данных уходит в облако, а решение о том, что куда, принимается по светофору данных, как и раньше.
С чего начать
Начинать стоит не с покупки. Возьмите свой нынешний компьютер, поставьте программу для запуска моделей — их несколько, все бесплатные, ставятся как обычное приложение, — скачайте небольшую модель и проверьте на своей настоящей задаче: расшифровка встречи, пересказ документа, черновик письма.
Через неделю такой работы вы будете точно знать две вещи: нужна ли вам локальная модель вообще и сколько памяти брать, если решите менять компьютер. Это знание стоит дешевле любой консультации и точнее любого обзора.
Практическая часть — установка, выбор модели под задачу и сборка личного помощника — разбирается в курсе «Личный помощник на своём компьютере» второй ступени.