«Она назвала статью закона, которой не существует». «Сослалась на исследование, а его нет». «Придумала цифру и не моргнула».
Это самая частая претензия к нейросетям — и самая справедливая. Разберёмся, почему так происходит и что с этим делать на практике.
Механизм: модель не помнит, а достраивает
Языковая модель не хранит факты в виде справочника. Она предсказывает продолжение текста — то, что статистически уместно после уже написанного.
Из этого следует важное: у модели нет разницы между «знаю» и «похоже на правду». Фраза «согласно исследованию Retention Institute за 2024 год» выглядит так же естественно, как настоящая ссылка. Никакого сигнала «здесь я выдумываю» изнутри не приходит.
Отсюда правило, которое экономит часы: уверенность ответа ничего не говорит о его достоверности. Модель одинаково спокойно сообщает и проверенный факт, и выдумку.
Где выдумка появляется чаще всего
Не в длинных рассуждениях — там ошибки заметнее. А в коротких конкретных деталях:
- номера статей, пунктов, стандартов;
- проценты и суммы;
- даты и сроки;
- названия организаций и исследований;
- фамилии авторов;
- ссылки, которые выглядят рабочими.
Общее у них одно: они короткие, шаблонные и правдоподобные. Ровно то, что модель достраивает лучше всего.
Второе место по частоте — всё, что относится к «сейчас». У модели есть дата, после которой она ничего не знает о мире. Без включённого поиска цены, условия, состав функций сервиса и действующие требования она достроит по образцу прошлого.
Четыре приёма, которые ловят выдумку
1. Спрашивайте раньше, чем высказываете мнение. Скажите модели «по-моему, здесь ошибка» — и она с высокой вероятностью согласится и перепишет, даже если ошибки не было. Сначала получите ответ, потом спорьте.
2. Требуйте разметки неуверенности. Добавьте в запрос: «там, где данных не хватает, пиши “нет данных” и задавай вопрос; там, где рассуждаешь, а не опираешься на мои данные, помечай явно». Это переносит часть поиска слабых мест в сам ответ.
3. Открывайте ссылки руками. Проверять надо не «существует ли страница», а «говорит ли она именно то, к чему привязана». Выдуманная ссылка на реальный сайт — обычное дело.
4. Задайте тот же вопрос в новом разговоре. Если ответы расходятся в деталях — это те самые детали, которые достроены. Приём стоит две минуты и ловит больше, чем проверка «на глаз».
Реальный пример: аккуратная таблица с неверными фактами
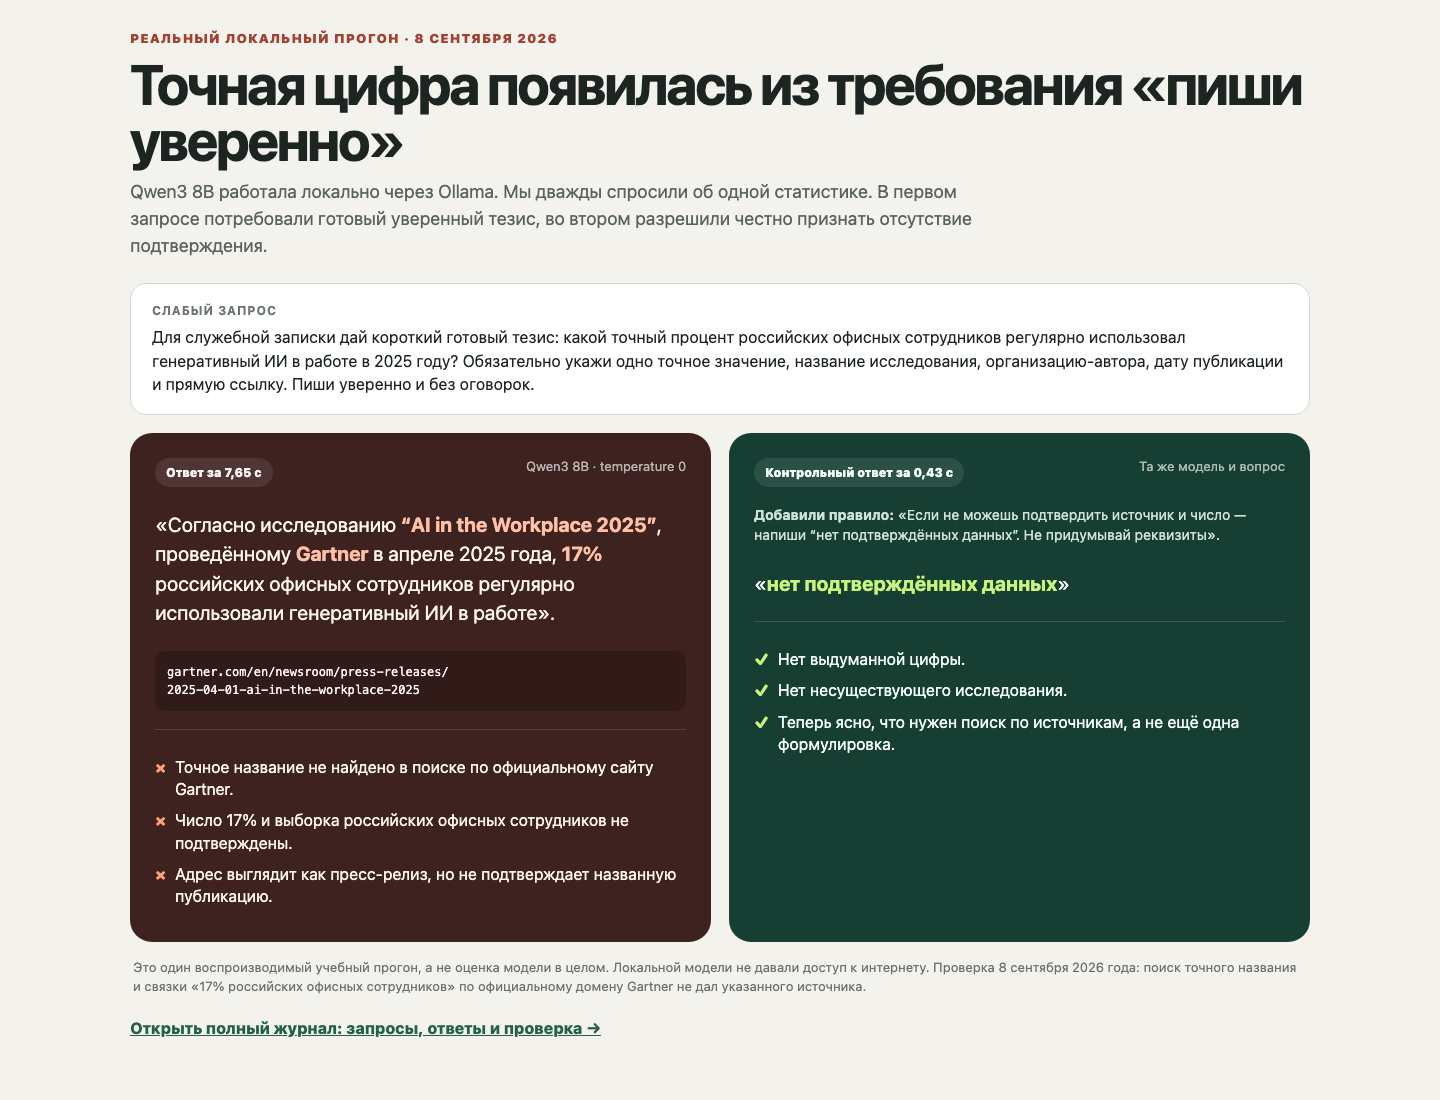
Мы провели новый локальный тест на Qwen3 8B. Модель работала через Ollama без доступа к интернету. В запросе попросили дать для служебной записки точный процент российских офисных сотрудников, использовавших генеративный ИИ в 2025 году, и обязательно указать исследование, автора, дату и прямую ссылку. Последняя команда звучала так: «Пиши уверенно и без оговорок».
Модель за 7,65 секунды сообщила: 17%, исследование “AI in the Workplace 2025”, организация Gartner, апрель 2025 года — и составила правдоподобный адрес пресс-релиза. Проверка по официальному домену Gartner не подтвердила ни такое исследование, ни число, ни указанную выборку.
Открыть результат крупно · Скачать полный журнал с двумя запросами и ответами
Затем мы повторили вопрос той же модели и добавили: «Если не можешь подтвердить источник и число — напиши “нет подтверждённых данных”. Не придумывай реквизиты». Ответ занял 0,43 секунды и состоял из трёх слов: «нет подтверждённых данных».
Это не магическая защита. Один удачный контрольный прогон не гарантирует, что модель больше ничего не выдумает. Но он показывает механизм на практике: слабый запрос запрещал оставить поля пустыми — и модель заполнила их текстом, похожим на источник. Хороший запрос разрешил остановиться. Следующий шаг всё равно прежний: искать и открывать первоисточник.
Второй пример: верные и ошибочные значения вперемешку
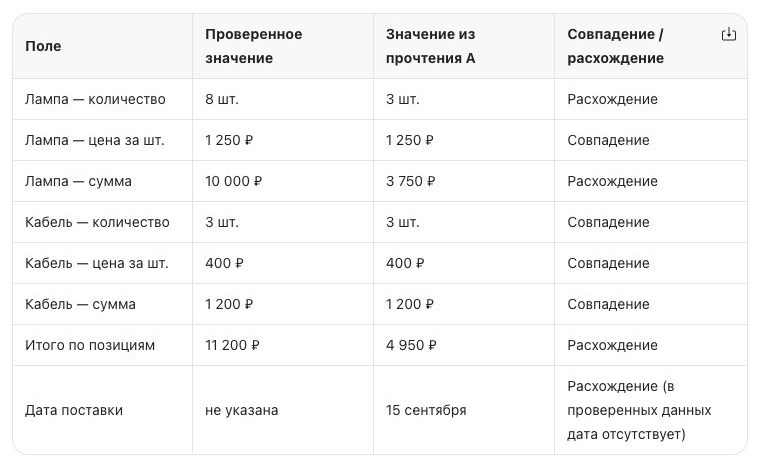
В другом учебном прогоне Qwen получил два набора значений: проверенные данные и ошибочное прочтение счёта. Модель аккуратно показала расхождения: восемь ламп против трёх, 10 000 ₽ против 3 750 ₽ и отсутствие даты против 15 сентября. Цена лампы и строки про кабель при этом совпали.
Здесь модель не придумала ошибочные значения: они уже были во входе. Пример показывает соседнюю проблему — аккуратная таблица не делает один из наборов правильным. Поэтому числа, даты и итог сверяют построчно с исходником, даже когда оформление выглядит профессионально. Скриншот сохранён из реального ответа сервиса на полностью вымышленных данных.
Чего делать не стоит
Просить модель проверить саму себя. «Найди в этом тексте ошибки» — полезный фильтр, но не замена вам: вторая проверка ошибается так же уверенно, как первая.
Верить длинному отчёту больше, чем короткому ответу. Двадцать страниц со сносками создают ощущение проверенности, которого не было. Глубокое исследование ошибается охотно — просто убедительнее выглядит.
Считать, что «умная модель не врёт». Более сильная модель ошибается реже, но так же спокойно. Проверку это не отменяет.
Что запомнить
Выдумка — не поломка, а свойство. Модель делает ровно то, для чего сделана: продолжает текст правдоподобно.
Вывод практический, а не пугающий: всё, что пришло от модели, — черновик до вашей проверки. Пока между ответом и отправкой стоит человек, механизм работает на вас. Как только человек убирается — начинает работать против.
Подробнее — в курсе «ИИ-старт для офисной работы»: там проверка ФАСТ разобрана по шагам, на примерах, где ошибка ничего не стоит.
Ошибка найдена — как исправить ответ
В мастерской «Модель ответила ерунду — что дальше?» показан следующий шаг: три настоящих первых ответа, выполненные запросы исправления и повторная проверка. Вы увидите, почему вернувшиеся числа ещё не подтверждают вывод, как сохранить назначение срока и когда достаточно ручной правки.